Projet Intelligence Artificielle
Voir le code GitHub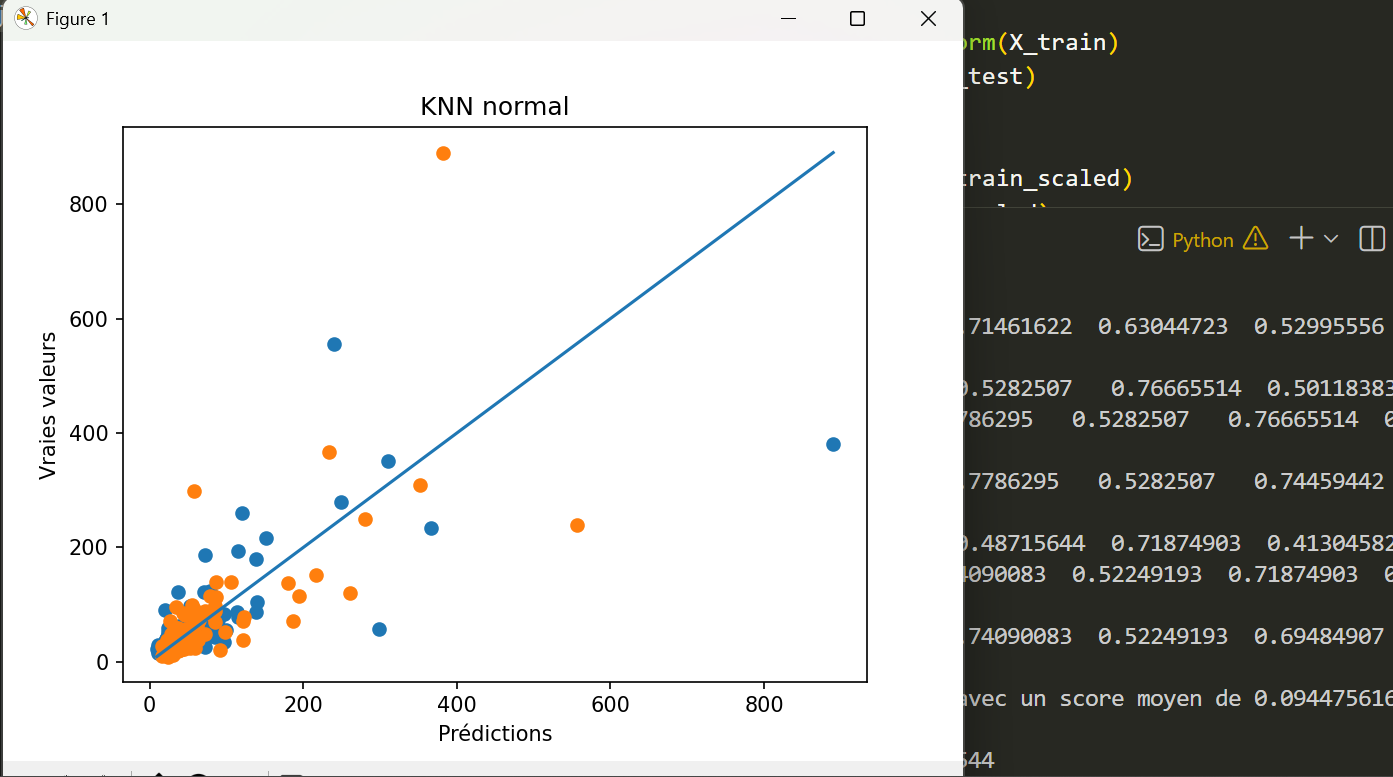
Ce projet met en place un pipeline complet de data science, allant du scraping automatisé de données sur un site de vins jusqu’à la construction et l’évaluation de modèles de machine learning pour la prédiction du prix des bouteilles.
L’objectif est de prédire le prix d’un vin à partir de ses caractéristiques (appellation, notes de critiques de Robert Parker, Robinson et James Suckling) afin d’analyser l’impact de ces variables sur la valorisation.
La collecte des données repose sur du web scraping avec Selenium et BeautifulSoup, permettant d’extraire automatiquement les informations depuis des pages dynamiques.
Une étape importante de feature engineering est réalisée : gestion des valeurs manquantes via moyennes par appellation, encodage des variables catégorielles et transformation des données pour les modèles.
Plusieurs modèles de machine learning sont ensuite testés (régression linéaire, KNN, arbres de décision et random forest), avec une évaluation basée sur le score R² et la validation croisée.
Enfin, une analyse de l’impact du prétraitement (normalisation, standardisation et PCA) est effectuée afin d’identifier les meilleures configurations pour améliorer les performances des modèles.
Le modèle KNN obtient les meilleures performances globales avec un score R² d’environ 0.50, devant les modèles de régression linéaire et les arbres de décision.
Les modèles ensemblistes comme Random Forest montrent également de bonnes performances, avec une stabilité supérieure et une meilleure capacité de généralisation.
L’analyse met en évidence que les notes des critiques (Robert Parker, Suckling, Robinson) sont fortement corrélées au prix et constituent les variables les plus prédictives du dataset.
Enfin, les tests de prétraitement (normalisation, standardisation et PCA) montrent un impact variable selon les modèles, sans amélioration significative pour les modèles basés sur les arbres.